Een server voor GLM-4.7-Flash: wat 10 tot 30 mensen nodig hebben
· Door Bee Flow · 6 min. lezen
Z.ai publiceerde GLM-4.7-Flash op 19 januari, een mixture-of-experts-model van 30B met zo'n 3B actieve parameters. Hoeveel videogeheugen het per kwantisatie vraagt, waarom het aantal mensen dat tegelijk iets vraagt de hardware bepaalt, en wanneer alleen een CPU volstaat.
Op 19 januari zette Z.ai de gewichten van GLM-4.7-Flash op Hugging Face, onder de MIT-licentie. De model card noemt het "a 30B-A3B MoE model": ongeveer 30 miljard parameters in totaal, waarvan er per token zo'n 3 miljard meedoen. De release notes van Ollama 0.14.3 noemen het model, en llama.cpp nam op de dag dat de gewichten verschenen ondersteuning voor de conversie op.
Gekwantiseerd past een model van dit formaat op één GPU, en de card zet de benchmarkcijfers naast modellen waarmee het zich vergelijkt. Voor een IT-beheerder blijft dan een praktische vraag over: wat koop ik voor twintig mensen? Dit stuk rekent dat uit met de model card en de documentatie van de runtimes, en zegt waar die documentatie ophoudt en je zelf moet gaan meten.
Wat er in het geheugen moet passen
Drie dingen delen de GPU: de gewichten, de KV-cache (het werkgeheugen van elk gesprek, met alles wat het model tot dan toe gelezen heeft) en de buffers van de runtime zelf.
De gewichten zijn het makkelijke deel. De bibliotheekpagina van Ollama geeft de grootte per kwantisatie:
| Ollama-tag | Grootte |
|---|---|
| q4_K_M (standaard) | 19 GB |
| q8_0 | 32 GB |
| bf16 | 60 GB |
De bf16-grootte klopt met de 31,2 miljard parameters die Hugging Face voor de BF16-gewichten opgeeft. De voorbeelden voor vLLM en SGLang in de model card draaien die volledige gewichten met een tensor-parallel-grootte van 4, dus verdeeld over vier GPU's. Voor een kantoor zijn de 4-bit- en 8-bitversies de realistische keuze.
Dat het een mixture of experts is, maakt het model niet kleiner. Per token zijn maar zo'n 3B parameters actief, maar welke dat zijn verschilt per token, dus alle 30B moeten geladen zijn. MoE scheelt rekenwerk per token. Het geheugen is dat van een 30B-model.
Bij de KV-cache gaat het rekenen meestal mis. De config van het model staat een context van 202.752 tokens toe, Ollama vermeldt 198K. Niemand heeft dat per persoon nodig, en je betaalt voor wat je instelt. De FAQ van Ollama bij deze versie zegt dat de standaardcontext 4.096 tokens is, aan te passen met OLLAMA_CONTEXT_LENGTH of num_ctx. Er staat ook wat er gebeurt als meer mensen tegelijk vragen stellen: parallelle verwerking vergroot de context met het aantal parallelle verzoeken. Het voorbeeld uit de FAQ: 2K context met 4 parallelle verzoeken wordt 8K context, met het extra geheugen dat daarbij hoort.
De som voor één kaart is dus: gewichten, plus context per verzoek maal het aantal parallelle verzoeken, plus overhead. Met de q4_K_M van 19 GB op een kaart van 24 GB zijn de paar gigabyte die overblijven je hele budget voor context en gelijktijdigheid. De q8_0 van 32 GB betekent een kaart van 48 GB of twee kaarten. Dezelfde FAQ biedt een knop om aan te draaien. Met flash attention aan (OLLAMA_FLASH_ATTENTION=1) gebruikt OLLAMA_KV_CACHE_TYPE=q8_0 volgens Ollama ongeveer de helft van het geheugen van f16, met een heel klein verlies aan precisie. q4_0 gebruikt ongeveer een kwart, met een verlies dat bij langere contexten meer kan opvallen.
Een cijfer per token voor de cache geven we hier niet. Dat hangt af van de runtime, het cachetype en hoe de runtime de attention-lagen van dit model afhandelt, en de ondersteuning in de runtimes is pas een paar dagen oud. Meet het liever: laad het model met de context en het aantal parallelle verzoeken die je wilt gebruiken en draai ollama ps. De FAQ legt de kolom PROCESSOR uit. 100% GPU is wat je wilt zien. Een verdeling als 48%/52% CPU/GPU betekent dat een deel van het model in het werkgeheugen van de server terecht is gekomen.
Gelijktijdigheid bepaalt de hardware
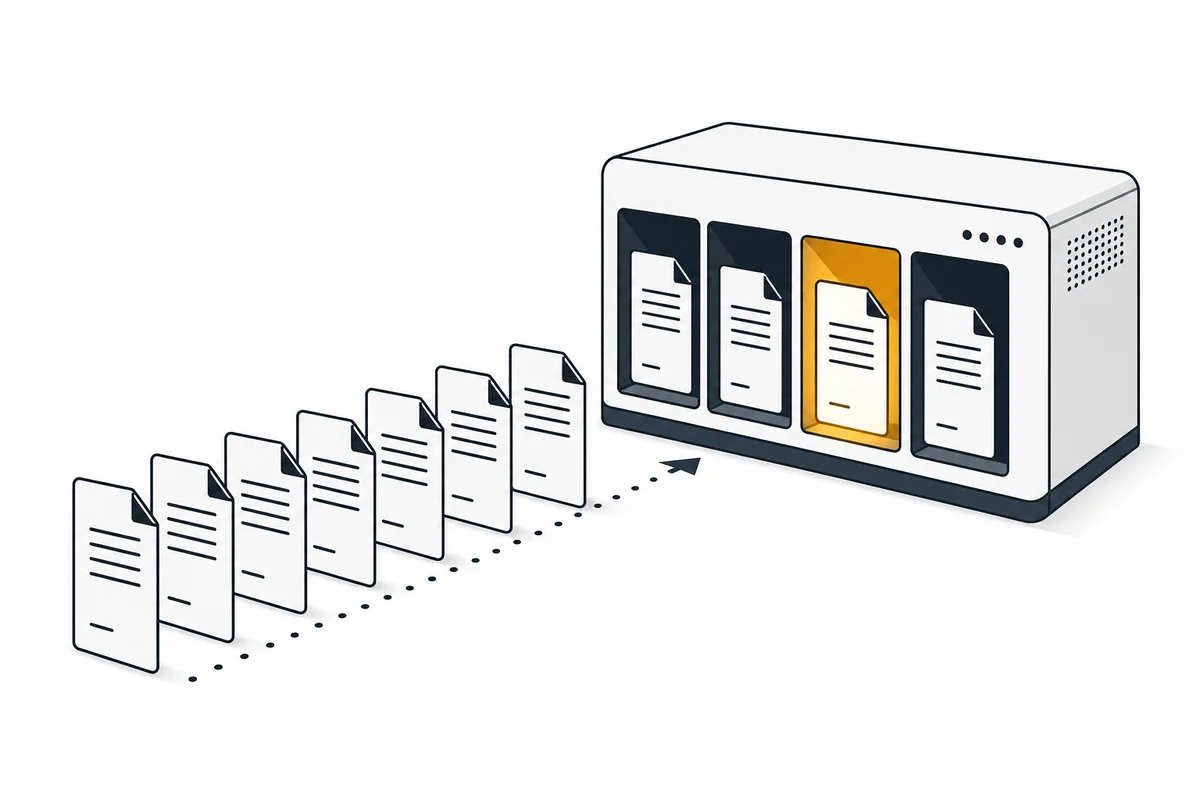
Een aantal tokens per seconde voor één gebruiker zegt weinig over twintig collega's. Het gaat erom hoeveel verzoeken er in dezelfde paar seconden binnenkomen, en wat de runtime daarmee doet.
Ollama regelt dat met twee instellingen uit dezelfde FAQ. OLLAMA_NUM_PARALLEL is het aantal verzoeken dat één model tegelijk verwerkt, en kiest standaard zelf 4 of 1, afhankelijk van het beschikbare geheugen. OLLAMA_MAX_QUEUE staat standaard op 512, daarna antwoordt de server met een 503. Verzoeken boven de parallelle limiet wachten op hun beurt. Bij een team dat vooral korte vragen stelt, merk je niets van die wachtrij. Plakken vijf mensen om negen uur 's ochtends een lang contract in de chat, dan is het die wachtrij die ze merken, lang voordat de snelheid van genereren ertoe doet.
vLLM is voor precies deze situatie gebouwd. De README noemt PagedAttention voor het beheer van de KV-cache en continuous batching van binnenkomende verzoeken: een nieuw verzoek schuift aan bij een batch die al loopt. De handleiding voor optimalisatie beschrijft de grens. Past niet alles meer in de KV-cache, dan zet vLLM verzoeken opzij en rekent ze later opnieuw uit, wat volgens de handleiding de doorlooptijd nadelig kan beïnvloeden. Als oplossing noemt de handleiding een hogere gpu_memory_utilization, het deel van het GPU-geheugen dat vLLM vooraf reserveert, of een lagere max_num_seqs. De server van llama.cpp werkt met een vast aantal slots: -np stelt ze in, -c de context, en continuous batching staat standaard aan (serverdocumentatie).
Onze vuistregel voor 10 tot 30 mensen: bepaal hoeveel verzoeken je tegelijk wilt bedienen zonder wachtrij, en met welke contextlengte, en koop daar geheugen voor. Een kaart waar de gewichten net in passen, bedient één persoon goed en een team slecht.
Nog één opmerking uit de model card zelf: bij de release ondersteunden vLLM en SGLang GLM-4.7-Flash alleen op hun main-branch, en de card verwijst naar nightly builds. Voor een productieserver zouden wij op een gewone release wachten, of beginnen met Ollama of llama.cpp en later naar vLLM overstappen.
Alleen CPU als terugvaloptie
llama.cpp draait op gewone processors. De README noemt ondersteuning voor AVX, AVX2, AVX512 en AMX op x86, kwantisatie van 1,5 tot 8 bit, en gemengd CPU- en GPU-gebruik om modellen die groter zijn dan het videogeheugen deels te versnellen. Ollama valt zonder GPU op dezelfde manier terug op het werkgeheugen.
Een mixture-of-experts-model is hiervoor het vriendelijkst, omdat er per token maar zo'n 3B parameters gelezen worden. De volle 19 GB moet nog steeds in het RAM staan, en elke prompt moet nog steeds verwerkt worden. Dat is het trage deel als mensen lange documenten plakken. Wij zouden alleen CPU gebruiken voor een pilot, voor een handvol gebruikers, of voor achtergrondtaken waar niemand op zit te wachten. Als hoofdchat voor dertig mensen niet. De documentatie geeft geen CPU-snelheden voor dit model, dus test op je eigen machine met je eigen documenten.
Waar het goed in is, en waar niet
De benchmarks in de card gaan vooral over redeneren, programmeren en agentwerk: 59,2 op SWE-bench Verified en 79,5 op τ²-Bench, tegen 22,0 en 49,0 voor Qwen3-30B-A3B-Thinking-2507 en 34,0 en 47,7 voor GPT-OSS-20B. Dat zijn metingen van Z.ai zelf. De API-documentatie van Z.ai raadt het ook aan voor schrijven, vertalen en lange teksten, en noemt tekst als enige invoer en uitvoer.
Wat de card niet zegt, telt voor een Nederlands kantoor. De metadata noemen Engels en Chinees. Over Nederlands, Duits of Frans staat er niets, dus probeer het met je eigen brieven en mails voordat je collega's iets belooft. Afbeeldingen leest het niet. En een model met 3B actieve parameters weet veel minder dan een groot gehost model: geef het bij vragen over je eigen procedures de documenten mee in plaats van te vertrouwen op wat het onthouden heeft. Voor moeilijke, open vragen zouden wij een groter model binnen bereik houden.
Waar Bee Flow past
Bee Flow is een werkomgeving voor chat, kennisbanken en automatiseringen die een model op je eigen hardware kan gebruiken naast modellen in de cloud en modellen die in de EU gehost worden. De dimensionering hierboven blijft jouw keuze: Bee Flow praat met de runtime die jij draait, bijvoorbeeld Ollama, en de prompts voor dat model gaan daarheen en blijven op je eigen netwerk. Medewerkers werken in één omgeving, en jij bepaalt welke taken het lokale model beantwoordt en welke naar een groter model gaan. Hoe de server en de runtime samen passen, staat op onze pagina over installatie. Wil je de dimensionering voor je eigen team doorrekenen, neem dan contact op.