Een model per taak: wat de drie formaten van Granite 4.2 zeggen over het verdelen van AI-werk
· Door Bee Flow · 6 min. lezen
IBM bracht Granite 4.2 op 25 augustus uit in 3B, 8B en 30B, alle drie op dezelfde benchmarks. Wat die tabel zegt over welk kantoorwerk een klein model aankan, waarvoor je een groot model nodig hebt, en wat het verdelen doet met de wachttijd en met de tekst die de deur uitgaat.
Op 25 augustus 2026 bracht IBM Granite 4.2 uit, een familie dense redeneermodellen in 3B, 8B en 30B, onder de Apache 2.0-licentie. IBM noemt onder meer Hugging Face, Ollama en LM Studio als plekken om ze te halen. Voor wie AI voor een kantoor beheert, zit het nuttigste deel van de release in een tabel. De model cards zetten de drie formaten naast elkaar op dezelfde benchmarks. Je ziet daardoor waar een tien keer zo groot model iets oplevert, en waar bijna niets.
Dat is precies de vraag achter een model per taak. Het meeste AI-werk op kantoor gebeurt rond de gesprekken die mensen met een chat voeren. Een chat een naam geven, een mail sorteren, een ordernummer uit een pdf halen: honderden kleine klussen per dag. Stuur je die allemaal naar het grootste model dat je hebt, dan worden ze traag. En draait dat model in de cloud, dan gaat elk van die teksten de deur uit.
Wat de tabel van Granite 4.2 laat zien
Dit zijn de cijfers van IBM zelf uit de model card, voor de modellen van 3B, 8B en 30B:
| Benchmark | Meet ongeveer | 3B | 8B | 30B |
|---|---|---|---|---|
| IFBench (prompt) | Opmaakinstructies volgen | 74,33 | 79,33 | 77,17 |
| BFCL v4 | Een functie correct aanroepen | 52,41 | 52,39 | 61,39 |
| τ³-bench (gem.) | Agenttaken over veel beurten en tools | 45,78 | 58,06 | 62,00 |
| RULER 128K | Feiten vinden en gebruiken in een heel lange invoer | 55,30 | 71,41 | 81,38 |
Benchmarks zijn een benadering, en deze komen van de leverancier zelf. Toch is het patroon duidelijk genoeg om mee te plannen. Instructies over opmaak volgen verandert nauwelijks met de grootte. Het 3B-model zit binnen vijf punten van de andere twee, en het 30B-model scoort zelfs iets lager dan het 8B-model. Op de test met één functieaanroep liggen 3B en 8B gelijk. De twee rijen die uit elkaar lopen gaan over lange invoer en agentwerk in meerdere stappen. Bij RULER op 128K tokens zakt het 3B-model naar 55, terwijl het 30B-model op 81 blijft.
Alle drie ondersteunen van zichzelf een context van 128K, uit te breiden tot 512K, volgens de card van het 3B-model. Een model dat een lange invoer accepteert, gebruikt die nog niet per se goed. Dat zie je in de RULER-rij.
Werk voor een klein model
De taken die goed passen bij een 3B-model hebben vier dingen gemeen: korte invoer, korte uitvoer, een vaste vorm en een antwoord dat iemand in één oogopslag kan controleren. Op kantoor gaat het dan om:
- een titel voor een gesprek of een document
- een mail of ticket in een van zes bekende categorieën zetten
- een samenvatting van drie regels van één mail
- een datum, een bedrag en een klantreferentie als JSON uit een tekst halen
De Granite-cards beschrijven drie standen, in te stellen via de chat template: thinking (standaard), non-thinking met enable_thinking=False, en een low-effort-stand met kortere redeneerketens. Voor een titel of een categorie zouden wij thinking uitzetten. Redeneertokens voor een antwoord van vier woorden zijn wachttijd zonder winst.
Werk voor een groot model
Lange documenten staan voorop. Een contract van 60 pagina's of een aanbesteding met bijlagen valt precies in het bereik waar de RULER-score van het kleine model wegzakt. Redeneren over meerdere bronnen is het tweede soort werk, bijvoorbeeld drie offertes toetsen aan een raamovereenkomst. Het derde is agentwerk met veel toolaanroepen achter elkaar. Elke stap bouwt voort op de vorige, dus een kleine fout aan het begin werkt vaak door tot het eind. Dat is wat τ³-bench test.
Onze eigen vuistregel, een inschatting en geen meting: alles met meer dan een handvol toolstappen, of met meer dan een paar duizend woorden invoer, begint op het grote niveau.
Twee of drie niveaus
In de praktijk heeft een kantoor genoeg aan twee of drie niveaus.
Het eerste is een klein model van 3B tot 4B voor achtergrondwerk waar niemand naar kijkt: titels, classificatie, gegevens uitlezen, korte samenvattingen. Het draait lokaal, de hele dag, zonder thinking.
Het tweede is een middelgroot model rond 8B voor de dagelijkse chat met tools: een antwoord opstellen, een korte vraag aan de kennisbank, één keer iets opzoeken.
Het derde niveau neemt lange documenten en moeilijk redeneerwerk voor zijn rekening. Dat kan een 30B-model op je eigen GPU zijn, een model bij een aanbieder met hosting in de EU, of een frontier-model in de cloud. Een veelgebruikte verdeling is een cloudmodel op dit niveau en de eerste twee in huis.
Verdeel per taak, niet per persoon. De collega die de lange analyse schrijft, veroorzaakt op een dag ook twintig titels en classificaties, en daar is het grote model voor geen van alle nodig.
Wat het doet met de wachttijd
Werk verdelen gaat vooral over wachtrijen. Een chattitel hoort niet te wachten achter een analyse van 40 pagina's op dezelfde GPU. Met aparte modellen antwoordt het kleine op de achtergrond terwijl het grote bezig is.
Of dat lukt, hangt af van de runtime. De Ollama FAQ beschrijft drie standaardwaarden die hier tellen. Een model blijft na de laatste vraag 5 minuten in het geheugen, aan te passen met OLLAMA_KEEP_ALIVE. Ollama houdt per GPU tot drie modellen tegelijk geladen (OLLAMA_MAX_LOADED_MODELS, drie keer het aantal GPU's). En is er te weinig VRAM voor een gevraagd model, dan komen nieuwe verzoeken in de wachtrij tot een ongebruikt model is uitgeladen.
Plan het geheugen dus zo dat het kleine en het middelgrote model samen geladen blijven, en zet de keep-alive voor die twee hoger. Anders betaal je bij elke wissel tussen niveaus met opnieuw laden. Hoeveel VRAM één model nodig heeft, is een aparte vraag. Die behandelden we in ons stuk over het dimensioneren van een server.
Wat het doet met tekst die de deur uitgaat
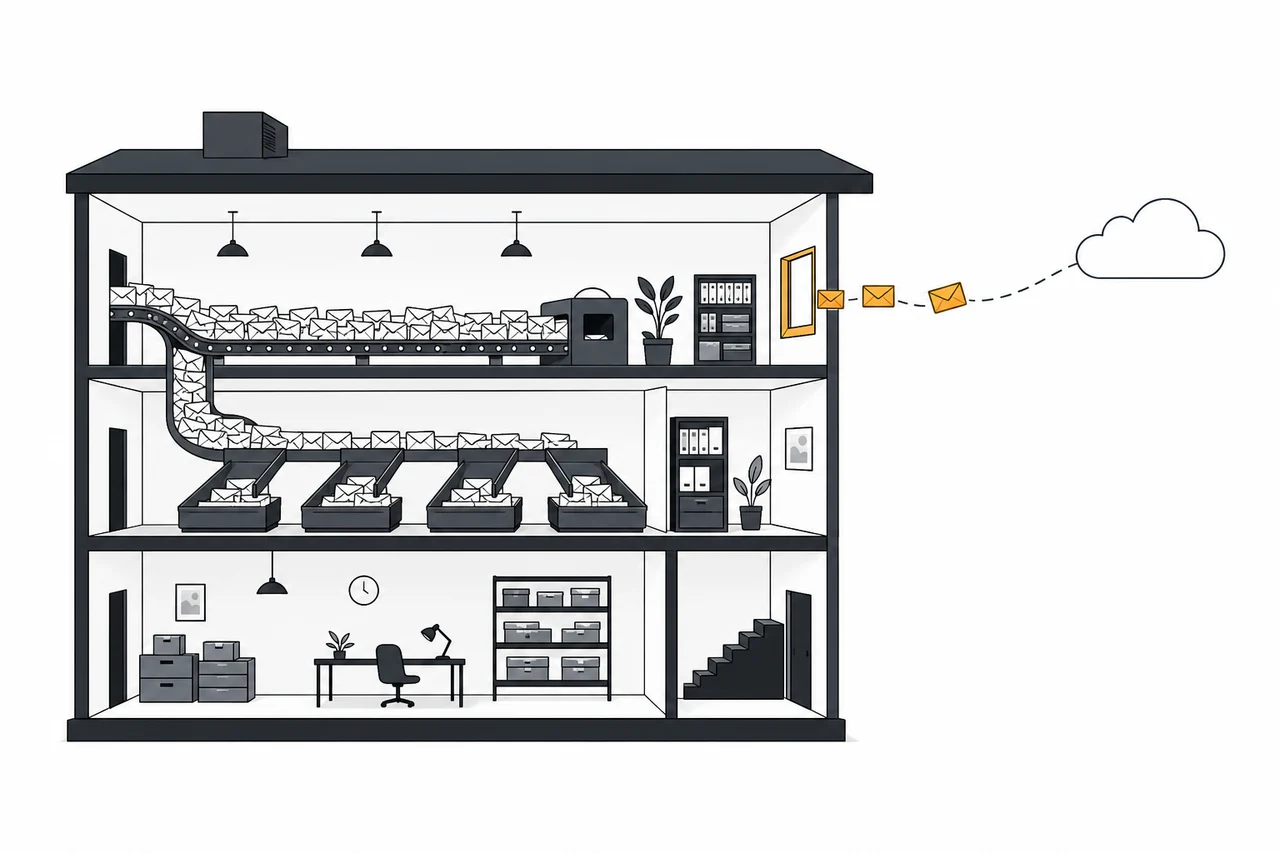
Tel aanroepen, geen gesprekken. Een verzonnen voorbeeld: een kantoor krijgt 300 mails per dag. Elke mail wordt geclassificeerd en de velden worden eruit gehaald, samen 600 aanroepen van een model. Misschien vijftien van die mails leiden tot een vraag waarvoor het grote model nodig is. Draaien de eerste twee niveaus lokaal en het derde in de cloud, dan gaan alleen die vijftien naar buiten. Staat alles op één cloudmodel, dan gaan alle 300 de deur uit, plus elke chattitel en elke samenvatting.
Daarom zou je het kleine model als eerste op je eigen hardware zetten. Het werk met het grootste volume is ook het meest routinematige, en het raakt de meeste persoonsgegevens, omdat het elke binnenkomende mail leest.
Hoe Bee Flow modellen aan taken koppelt
Bee Flow werkt met niveaus: Fast, Flow, Thinking en Deep Thinking, elk gekoppeld aan één model op de pagina Chat Models in de beheerinstellingen. Lokale runtimes zoals Ollama, vLLM en llama.cpp staan in die keuzelijst naast cloudaanbieders en aanbieders met hosting in de EU. Een lokaal model op Fast en een cloudmodel op Deep Thinking is dus één keuze per niveau. Achtergrondtaken zoals chattitels, het vastleggen van geheugen en het uitlezen van velden met AI in automatiseringen gebruiken het Fast-niveau. Een AI-stap in een automatisering kan een eigen niveau krijgen of op automatisch blijven staan, waarbij een snelle controle van het bericht en daarna het snelle model het niveau kiezen. Met de EU-modus aan neemt een aparte set modellen per niveau het over, en Privacy Shield controleert prompts op persoonsgegevens binnen je eigen installatie voordat ze een model bereiken. Op de platformpagina zie je hoe niveaus, agents en automatiseringen samenhangen, en bij automatisering als dienst richten wij de automatiseringen en hun niveaus voor je in. Bekijk de mogelijkheden voor eigen hosting en EU-cloud, of vraag ons hoe je de niveaus indeelt voor de modellen die jij draait.