Vergaderingen uitschrijven zonder dat het geluid het gebouw verlaat
· Door Bee Flow · 6 min. lezen
Op 26 maart bracht Cohere een open spraakherkenningsmodel uit dat ook Nederlands kent. Wat notulen op je eigen server aan hardware vragen, wat je deelnemers vertelt, hoe lang je het geluid bewaart en wat de samenvatting toevoegt.
Op 26 maart 2026 bracht Cohere een spraakherkenningsmodel uit dat iedereen zelf mag draaien: Cohere Transcribe, 2 miljard parameters, onder de Apache 2.0-licentie en met Nederlands als een van de veertien talen. Daarmee is er naast OpenAI's Whisper nog een open model waarmee je een opname kunt uitschrijven op een computer die van jou is.
Voor een kantoor met een wekelijks werkoverleg is dat meer dan techniek. Een vergaderopname is vaak een van de meest persoonlijke bestanden die je hebt. Er staan stemmen op, meningen over klanten, soms een opmerking over de gezondheid van een collega. Wie die opname naar een online dienst stuurt om hem te laten uitschrijven, geeft al die dingen mee. Wie hem op de eigen server uitschrijft, houdt ze binnen.
Twee stappen, twee keuzes
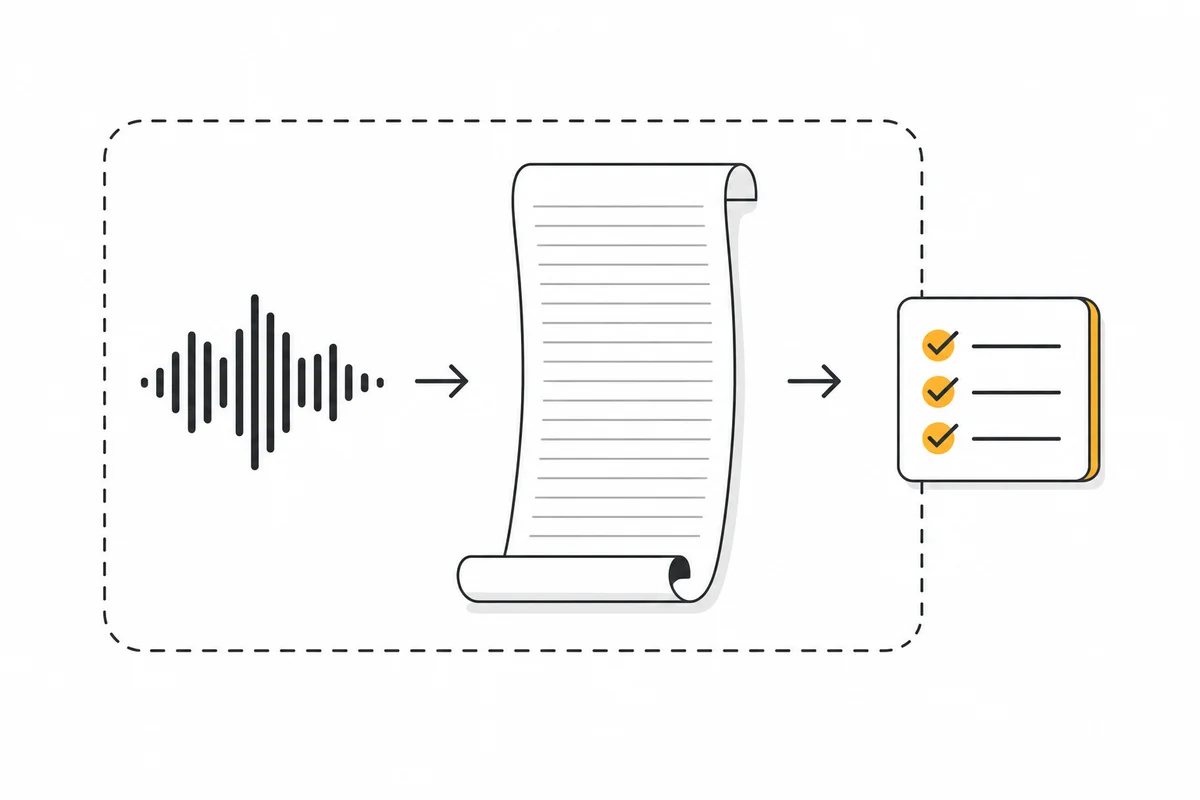
Van opname naar verslag zijn twee stappen. Eerst wordt spraak tekst, dan maakt een taalmodel van die tekst een samenvatting. Elke stap kan in huis gebeuren of bij een externe dienst, en dat hoeft niet dezelfde keuze te zijn.
Houd dat onderscheid vast als je met je IT-collega praat. Een lokaal spraakmodel lost alleen de eerste stap op. Gaat het uitgeschreven gesprek daarna naar een taalmodel in de cloud, dan verlaat de inhoud alsnog het gebouw, alleen nu als tekst.
Notulen op eigen server: wat het aan hardware vraagt
De handleiding van Whisper geeft per modelgrootte een richtlijn voor het geheugen van de videokaart: ongeveer 2 GB voor small, 5 GB voor medium, 6 GB voor turbo en 10 GB voor large (Whisper README). Dezelfde pagina zegt erbij dat de snelheid in de praktijk sterk kan verschillen.
De modelkaart van Cohere Transcribe noemt geen minimale hardware. Wel staat er hoe je het model draait met de Transformers-bibliotheek en met vLLM, een server voor productiegebruik. Onze eigen rekensom: 2 miljard parameters in 16-bit precisie zijn ongeveer 4 GB aan gewichten, dus een videokaart met 8 GB lijkt ons een redelijk beginpunt. Dat is een schatting, geen opgave van de maker.
Zonder videokaart kan het ook. WhisperX, een veelgebruikte schil om Whisper heen, beschrijft hoe je het op de processor draait. Dat werkt, maar reken op wachten. Voor één overleg per week is dat geen probleem. Voor tien gesprekken per dag wel.
Ons advies aan de IT-collega: neem drie echte opnames uit je eigen vergaderruimte, met de eigen microfoon en de gebruikelijke rommel op de achtergrond, en kijk hoe lang het uitschrijven duurt en hoeveel je moet verbeteren. Dat zegt meer dan elke ranglijst.
Nederlands, volgens de makers zelf
Beide modellen noemen Nederlands. Whisper heeft het in zijn lijst met talen, en de handleiding waarschuwt dat de kwaliteit sterk per taal verschilt. Cohere zet Nederlands bij de veertien ondersteunde talen en schrijft dat het model in de dertien talen naast Engels gelijk scoort met of beter scoort dan het beste open model op de tests die Cohere zelf bijhoudt (aankondiging). Dat zijn de cijfers van de maker zelf.
De modelkaart van Cohere noemt ook een paar grenzen die bij vergaderingen gaan tellen:
- Je geeft vooraf de taal op. Het model herkent de taal niet zelf en doet het wisselend bij gesprekken waarin talen door elkaar gaan. Een overleg in het Nederlands met Engelse vaktermen is dus iets om te testen.
- Het geeft geen tijdcodes en verdeelt het gesprek niet per spreker. Voor een verslag met "wie zei wat" heb je een extra stap nodig.
- Het schrijft ook geluiden uit die geen spraak zijn, wat tot verzonnen tekst kan leiden. Cohere raadt aan er een stap voor te zetten die stilte en ruis eruit filtert.
Dat laatste weegt bij vergaderingen zwaar. Een overleg heeft pauzes, schuivende stoelen en iemand die koffie haalt. Het opdelen per spreker doet WhisperX met een apart model van pyannote, waarvoor je een gratis account bij Hugging Face nodig hebt. Hoe goed dat werkt, zegt WhisperX eerlijk: het is "far from perfect" en door elkaar praten gaat slecht.
Een Teams-opname achteraf transcriberen
Uitschrijven hoeft niet tijdens het overleg te gebeuren. Een opname die je in Teams hebt gemaakt, is daarna een gewoon bestand. Dat bestand kun je achteraf op je eigen server laten uitschrijven, zonder dat er tijdens de vergadering een extra deelnemer of bot meeluistert. Hetzelfde geldt voor een opname uit Google Meet of Nextcloud Talk, en voor een fysieke vergadering die je met een telefoon of een microfoon op tafel opneemt.
De regels hieronder gelden dan net zo goed. Wie wordt opgenomen, hoort dat vooraf, en de opname in Teams zelf heeft ook een bewaartermijn nodig.
Wat je deelnemers vertelt
Wie een vergadering opneemt, verwerkt persoonsgegevens. De AVG zegt dat je mensen bij het verzamelen een aantal dingen vertelt, onder meer wie de gegevens ontvangt, of ze naar een land buiten de EU gaan en hoe lang je ze bewaart (artikel 13 AVG).
Lokaal uitschrijven maakt dat verhaal een stuk korter. Je kunt zeggen: "We nemen dit op voor het verslag. Het geluid blijft op onze eigen server, gaat naar geen andere partij, en we verwijderen het als het verslag is goedgekeurd." Zet dezelfde zin in de uitnodiging, zodat niemand pas bij de start hoort dat er wordt opgenomen. Zitten er externe gasten bij, vraag dan aan het begin of iedereen daarmee akkoord is, en spreek af wat je doet als iemand nee zegt.
Leg die afspraken één keer vast, bijvoorbeeld in je AI-beleid op één pagina, dan hoeft niemand per vergadering te bedenken wat er mag.
Dit artikel is geen juridisch advies. Twijfel je, vraag het dan aan je privacyfunctionaris.
Hoe lang je het geluid bewaart
De AVG zegt dat je persoonsgegevens niet langer bewaart dan nodig is voor het doel waarvoor je ze verwerkt (artikel 5, lid 1, onder e, AVG). Een vaste termijn voor vergaderopnames staat er niet in. Die kies je zelf, en je moet hem kunnen uitleggen.
Ons voorstel: zie het geluid als grondstof. Het is nodig tot het uitgeschreven gesprek en het verslag zijn nagelezen. Daarna heeft het zijn werk gedaan. Een week is voor de meeste teams ruim genoeg. Het verslag bewaar je zo lang als je andere vergaderstukken.
Twee dingen worden vaak vergeten. De volledige uitgeschreven tekst bevat dezelfde persoonsgegevens als het geluid, dus die verdient ook een termijn. En een opname die je van de server verwijdert, staat soms nog weken in een back-up. Vraag je IT-collega hoe lang de back-ups teruggaan en noem die termijn eerlijk als iemand ernaar vraagt.
Wat een samenvatting toevoegt
Een uur overleg levert al snel meer tekst op dan iemand wil lezen. Het uitschrijven is het ruwe materiaal. Pas de samenvatting maakt er een verslag van: wat besloten is, wie wat gaat doen en voor wanneer. Dat is waar het tijd bespaart.
Die stap is ook het moment waarop je weer moet kiezen waar het gebeurt. Een taalmodel op je eigen hardware vraagt meer dan een spraakmodel, zie ons stuk over het dimensioneren van een server. Een model bij een Europese aanbieder is een middenweg: het geluid blijft in huis, de tekst gaat naar een partij met wie je een verwerkersovereenkomst hebt.
Lees de samenvatting altijd na voordat je hem rondstuurt. Een taalmodel kan een besluit aan de verkeerde persoon toeschrijven of een "misschien" lezen als een "ja". Met het uitgeschreven gesprek ernaast is dat in een paar minuten gecontroleerd.
Hoe Bee Flow hierbij helpt
Bee Flow maakt van een opname een verslag met een samenvatting en actiepunten, en het uitschrijven kan op je eigen server gebeuren met WhisperX. Het geluid hoeft dan niet naar een externe dienst. Er is ook een ingebouwde optie zonder extra service: een klein Whisper-model dat op de processor draait, standaard voor opnames tot ongeveer tien minuten. Voor hele vergaderingen op eigen hardware heb je WhisperX op een stevige server nodig. Je neemt op of uploadt een bestand, of je haalt een opname achteraf binnen uit Microsoft Teams, Google Meet of Nextcloud Talk. Notulen zitten in de Pro-licentie.
De samenvatting schrijft het taalmodel dat je organisatie heeft gekozen, en Bee Flow zelf kun je ook op je eigen server draaien. Hoe dat eruitziet, lees je op notulen en bij je eigen server of Bee Flow Cloud. Wil je het met een opname van je eigen overleg proberen, neem contact op.